엑셀 / 함수 / LEFT, LEFTB, MID, MIDB, RIGHT, RIGHTB / 문자열 추출 함수
LEFT는 문자열의 앞에서, MID는 지정한 위치에서, RIGHT는 끝에서 문자를 추출합니다. 위치는 1부터, 길이는 문자 수로 지정합니다. LEFTB·MIDB·RIGHTB는 기존 바이트 기준 함수이며 Microsoft의 현재 문서에서는 사용 중단 예정으로 안내하므로 새 수식에는 문자 기준 함수를 우선 검토하세요.
LEFT: 앞부분 추출
=LEFT(text,[num_chars])
=LEFT("ABCDE",2)
문자열의 앞부분을 추출한 예입니다. 위 수식은 AB를 반환합니다. num_chars를 생략하면 한 글자를 가져오고 0이면 빈 문자열, 전체 길이보다 크면 전체 문자열을 반환합니다.
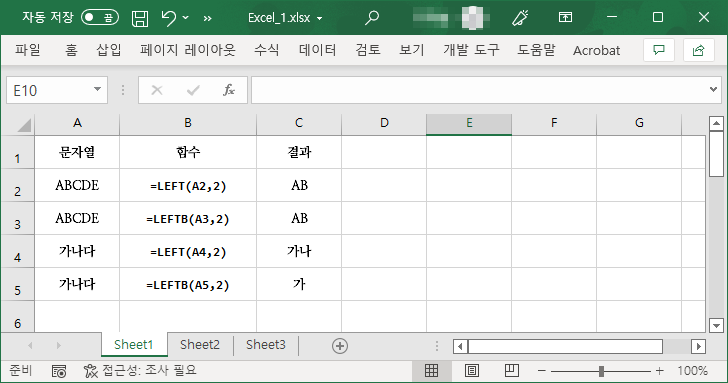
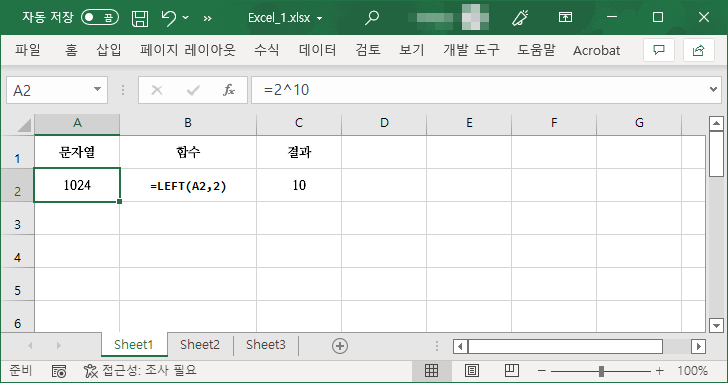
계산 결과나 다른 셀의 값을 LEFT로 추출한 예입니다. 숫자나 날짜를 텍스트로 다룰 때는 화면의 표시 형식이 그대로 유지된다고 가정하지 마세요.
MID: 중간 부분 추출
=MID(text,start_num,num_chars)
=MID("ABCDE",2,3)
시작 위치와 길이를 지정한 MID·MIDB 비교 예입니다. 문자 기준의 위 수식은 두 번째 문자부터 세 글자인 BCD를 반환합니다.
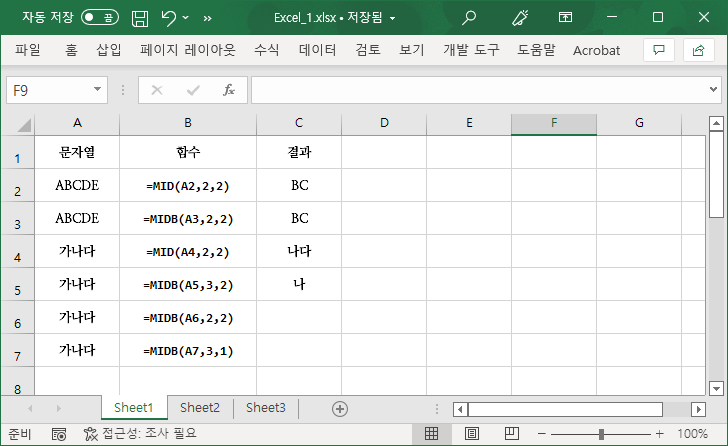
start_num가 문자열 끝을 넘으면 빈 문자열을 반환하고, 추출 길이가 남은 문자열보다 길면 끝까지 반환합니다. 시작 위치가 1 미만이거나 길이가 음수이면 #VALUE! 오류가 날 수 있습니다.
RIGHT: 끝부분 추출
=RIGHT(text,[num_chars])
=RIGHT("ABCDE",2)
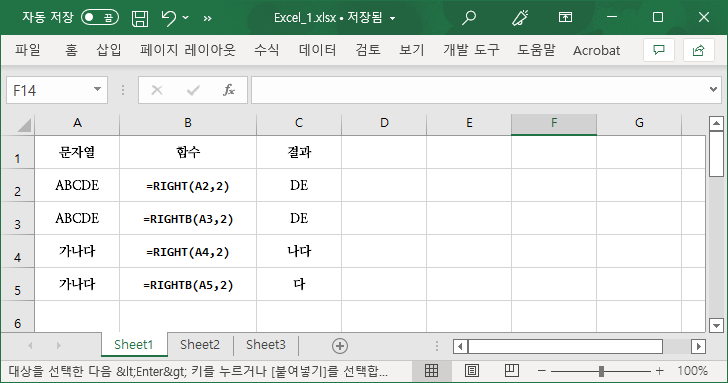
문자열 끝의 문자를 추출한 예입니다. 위 수식은 DE를 반환합니다. LEFT와 마찬가지로 길이를 생략하면 한 글자를 가져옵니다.
구문과 지원 제품은 Microsoft의 LEFT 함수 설명, Microsoft의 MID 함수 설명, Microsoft의 RIGHT 함수 설명에서 확인할 수 있습니다.
B 계열 함수와 한글·이모지
기존 B 계열의 바이트 계산은 더블바이트 문자 지원 언어 환경 등의 조건에 영향을 받으며 UTF-8 파일의 바이트 크기와 같지 않습니다. 한글은 무조건 2로 센다고 단정하지 말고 해당 파일의 수식과 환경을 확인합니다. 문자 중간을 바이트 단위로 끊으면 원하는 글자를 얻지 못할 수 있습니다.
호환성 버전 2의 통합 문서에서는 일부 유니코드 서로게이트 쌍을 세는 동작이 개선되었습니다. 화면에서 하나처럼 보이는 이모지가 언제나 문자 하나인 것은 아니므로 이모지 포함 데이터는 예제로 확인하세요.
문자의 위치가 고정되지 않고 @·하이픈 같은 구분자를 기준으로 잘라야 한다면 특정 문자 앞뒤 추출을 사용합니다. 추출 결과가 텍스트라는 점도 숫자 계산 전 확인하세요.
실제 날짜와 1일·7일 증가 수식으로 달력을 만드는 방법을 설명합니다. 월 시작 요일, 다른 달 날짜, 날짜 표시 서식과 템플릿 대안도 안내합니다.
엑셀 / 하이퍼링크 제거하는 방법, 자동 하이퍼링크 안 생기게 하는 방법
기존 하이퍼링크를 제거하거나 입력 시 자동 생성을 끄는 방법을 설명합니다. 텍스트·서식 보존과 HYPERLINK 수식의 별도 처리도 안내합니다.

여러 조건 LOOKUP 수식의 논리값·나눗셈 구조를 설명합니다. 마지막 일치 반환과 미일치·중복의 한계, XLOOKUP 대안을 함께 안내합니다.
엑셀 / 함수 / VLOOKUP, HLOOKUP, XLOOKUP
VLOOKUP·HLOOKUP·XLOOKUP의 조회 방향과 정확히 일치 옵션을 비교합니다. 범위 고정, 중복 값, 다중 열 반환과 조회 오류를 해결하는 기준도 안내합니다.
병합하고 가운데 맞춤·전체 병합·셀 병합·셀 분할을 비교합니다. 병합 과정의 데이터 손실, 해제의 한계와 표 편집에 미치는 영향도 설명합니다.

엑셀 / 함수 / DELTA / 두 숫자가 같은지 비교하는 함수
DELTA가 같은 숫자에 1, 다른 숫자에 0을 반환하는 방식과 기본값을 설명합니다. 소수 계산 오차가 있는 수를 비교할 때의 한계도 다룹니다.
엑셀 / 양수(이익)를 빨간색, 음수(손실)를 파란색으로 만드는 방법
조건부 서식과 사용자 지정 숫자 형식으로 양수·음수의 색을 구분합니다. 0·텍스트·소수 자리 표시와 색 외의 구분·규칙 충돌도 확인합니다.
보조 열과 SUMIF로 월별 합계를 구하는 방법, SUMIFS 날짜 구간으로 연도까지 구분하는 방법을 설명합니다. 기존 배열 수식의 버전별 입력 차이도 다룹니다.
엑셀 / 함수 / XIRR / 비정기적인 현금 흐름의 내부수익률 계산하는 함수
XIRR의 금액·날짜 범위를 맞추고 연 단위 내부수익률을 계산하는 방법을 안내합니다. IRR과 다른 점, 날짜 오류와 추정값의 한계도 설명합니다.
엑셀 / 피벗 테이블 / 여러 범위로 다중 피벗 테이블 만드는 방법
기존 다중 통합 범위 피벗 마법사로 여러 요약 범위를 합치는 방법을 설명합니다. 필드 분석의 한계·범위 추가·새로 고침과 Power Query 대안도 다룹니다.