엑셀 / 함수 / LEN, LENB / 문자열의 문자 수, 바이트 수 구하는 함수
LEN은 문자열의 문자 수를 반환하고 공백도 문자로 셉니다. LENB는 기존 바이트 기준 길이 함수이며 Microsoft의 현재 문서에서는 사용 중단 예정으로 안내합니다. LENB 결과를 UTF-8 파일이나 전송 데이터의 실제 바이트 크기라고 해석해서는 안 됩니다.
LEN 구문과 기본 예제
=LEN(text)
=LEN("ABCDE")
=LEN("AB CD")
=LEN("")
결과는 각각 5, 5, 0입니다. 셀 참조를 사용하면 =LEN(A2)처럼 쓰고, 숫자를 참조하면 셀의 표시 형식보다 실제 값의 텍스트 표현이 기준이 됩니다.
구문과 지원 제품은 Microsoft의 LEN 함수 설명에서 확인할 수 있습니다.
LEN과 LENB를 영문·공백·한글이 섞인 문자열에 적용한 기존 예제입니다. LEN("가나다라")는 한글 네 글자를 세어 4를 반환합니다.

LENB의 바이트 수가 뜻하는 것
한국어 등 더블바이트 문자 지원 언어를 기본 언어로 사용하는 기존 환경에서는 LENB가 한글 한 문자를 2로 셀 수 있습니다. 그렇지 않은 환경에서는 LEN과 같은 결과가 나올 수 있으므로 ‘한글은 항상 2바이트’로 단정하지 마세요.
UTF-8로 저장한 파일에서는 다른 바이트 수를 사용할 수 있고 파일 전체 크기에는 구분자·줄바꿈 등도 들어갑니다. 파일 크기 검사나 업로드 제한 판단은 해당 인코딩·전송 방식에서 실제 바이트 수를 계산해야 합니다.
공백과 이모지의 주의점
앞뒤 공백은 LEN의 결과에 포함됩니다. 눈으로 같아 보이는 문자열의 길이가 다르면 공백·줄바꿈·숨은 문자가 있는지 확인합니다. TRIM은 일부 공백을 정리하지만 모든 종류의 보이지 않는 문자를 제거하지는 않습니다.
호환성 버전 2의 통합 문서에서 LEN은 유니코드 서로게이트 쌍을 한 문자로 세는 동작이 개선되었습니다. 그러나 이모지의 변형 선택자 등은 별도 문자로 셀 수 있어 화면에서 보이는 기호 개수와 항상 같지는 않습니다. 이모지 포함 자료는 사용하는 Excel과 통합 문서 환경에서 확인하세요.
문자 수를 이용해 텍스트 일부를 자르는 방법은 LEFT·MID·RIGHT와 함께 사용할 수 있습니다.
실제 날짜와 1일·7일 증가 수식으로 달력을 만드는 방법을 설명합니다. 월 시작 요일, 다른 달 날짜, 날짜 표시 서식과 템플릿 대안도 안내합니다.
병합하고 가운데 맞춤·전체 병합·셀 병합·셀 분할을 비교합니다. 병합 과정의 데이터 손실, 해제의 한계와 표 편집에 미치는 영향도 설명합니다.
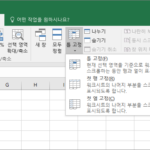
선택 셀 위·왼쪽의 행·열을 틀 고정하는 방법을 설명합니다. 첫 행·첫 열 고정, 취소와 인쇄 제목 설정의 차이도 안내합니다.

엑셀 / 함수 / ADDRESS / 셀 주소 확인하는 함수
ADDRESS의 행·열 번호와 절대·상대 참조 옵션을 예제로 설명합니다. A1·R1C1 형식, 시트 이름과 반환 문자열의 한계도 다룹니다.
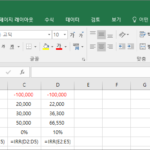
IRR에 주기적인 현금흐름을 입력하고 결과를 해석하는 방법을 설명합니다. 부호, 기간, 추정값과 수렴 오류를 확인하며 XIRR과의 차이를 구분할 수 있습니다.
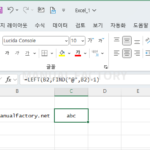
이메일의 @ 앞 사용자 부분을 추출하는 수식과 예제를 안내합니다. 누락·중복 @ 및 공백 처리와 개인정보 식별의 한계도 설명합니다.
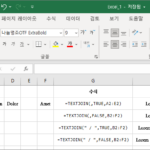
엑셀 / 함수 / TEXTJOIN / 여러 텍스트를 하나로 합치는 함수
TEXTJOIN의 구분자·빈 셀 옵션을 비교하고 여러 셀을 한 문장으로 연결하는 예제를 안내합니다. 날짜·숫자 서식과 결과 길이 제한도 설명합니다.

페이지 나누기 점선을 숨기는 Excel 옵션과 복원 방법을 설명합니다. 표시 숨김, 수동 페이지 나누기 삭제와 실제 인쇄 배치 변경을 구분합니다.
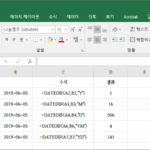
엑셀 / 함수 / DATEDIF / 두 날짜 사이의 일수, 월수, 년수 등을 계산하는 함수
DATEDIF로 완성된 연수·월수와 날짜 차이를 구하는 방법을 설명합니다. 인수 순서, 공식 문서에 안내된 MD의 한계, 윤년·월말 확인 사항도 다룹니다.
엑셀 / 화살표 키 눌렀을 때 스크롤 되는 현상 해결하는 방법
화살표가 셀 대신 화면을 움직일 때 Scroll Lock 상태를 확인합니다. 키가 없는 키보드의 화면 키보드 사용과 다른 입력 상태의 점검도 안내합니다.